登录 / 注册
选购合适的版本
构建数字孪生新世界
J3D数字孪生开发平台
RBI商业智能开发平台
模型资源
场景素材
空间&流量
立即查看
首页 > 资讯动态 > 算力调度:释放智能时代的底层生产力

算力调度:释放智能时代的底层生产力

日期:2026-11-03
字号
分享


算力调度:释放智能时代的底层生产力


大模型训练、科学计算、自动驾驶仿真、渲染农场——这些曾经各自独立的算力需求,如今正在同一个数字底座上交汇。算力已经像水和电一样,成为智能时代不可或缺的生产要素。然而,一个普遍的现实矛盾是:一边是海量算力在闲置排队,另一边是业务方一卡难求。问题往往不在于算力总量不足,而在于调度不够精细。

什么是算力调度。它是指在异构、分布式的算力资源池中,根据任务的优先级、资源需求和时限要求,自动完成资源分配、任务编排和动态迁移的过程。如果说芯片和服务器是"发电厂",那么算力调度就是"智能电网"——它决定了电力从哪里来、输送到哪里、按什么价格、保障什么质量。好的调度系统,能让闲置GPU在夜间跑离线训练,在白天腾出显存服务在线推理;能让一个千亿参数模型的训练任务,自动找到跨机房的空闲节点并行启动。
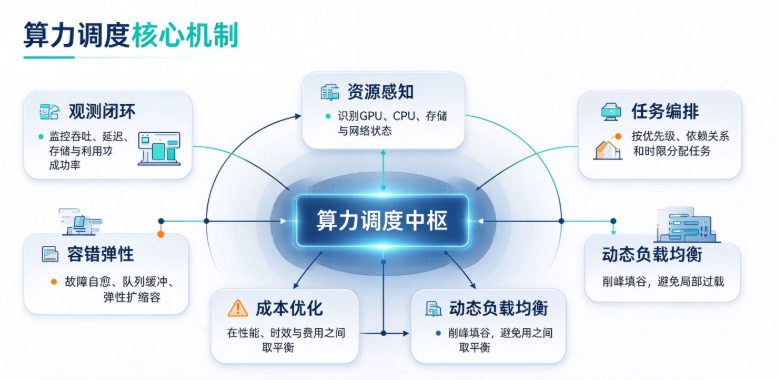
资源感知是调度的前提。调度系统首先要实时掌握全局资源家底:哪些节点空闲、显存余量多少、网络带宽裕度多大、电力成本处于高峰还是低谷。没有这张动态更新的资源地图,任何调度都只是盲人摸象。现代调度平台通常通过容器编排框架和设备监控组件,把成千上万张GPU卡、CPU节点和存储阵列统一抽象成可调度的资源池。
任务编排是调度的核心。不同任务对算力的需求差异极大:大模型训练需要多卡高速互联、吞吐优先;在线推理要求低延迟、随时可扩;批量数据处理则可以在闲时"插队"运行。调度系统需要根据任务类型自动匹配最合适的资源组合,并处理好任务间的依赖关系——前一个数据清洗任务完成后,下游的模型训练才能启动,整条流水线要像流水线工厂一样自动流转。
动态分配与负载均衡是效率的关键。真实业务的负载从来不是平稳的:早高峰在线服务请求激增,深夜则是离线批处理的黄金窗口。调度系统需要持续观察每个节点的负载水位,把任务从繁忙节点迁移到空闲节点,避免个别机器过载、而旁边机器空转的浪费。在跨数据中心的场景下,还要考虑网络延迟和数据就近性——把计算任务调度到离数据最近的地方,比远距离搬运数据要高效得多。
成本优化是调度的新维度。算力是昂贵的资源。一张高端训练GPU的成本动辄数十万元,电费和机房租金更是长期开销。智能调度会把离线任务自动安排到电价低谷时段执行,把对延迟不敏感的任务调度到算力价格更低的可用区,甚至在业务低谷期自动关停部分节点以节省能耗。这种"潮汐式"调度能让整体算力成本下降可观的比例。
容错与弹性是稳定性的底线。大规模集群中,单台服务器故障是常态而非例外。训练任务一旦中途失败,调度系统需要自动把任务迁移到健康节点,从最近的检查点恢复,而不是从头再来。同时,面对突发流量洪峰,调度系统还能秒级扩容资源池;流量回落后再自动缩容,避免资源空耗。
在实际落地中,算力调度正在三类场景中快速成熟。智算中心依托它把多厂商、多型号的GPU统一纳管,提升千卡级集群的利用率;公有云厂商用它向企业客户提供弹性、按量计费的算力服务;科研与高校则通过跨机构的算力互联网,让分散的超算资源服务于全国的科研团队。无论哪类场景,最终的目标都是一致的——让每一块芯片都尽可能跑在高价值任务上,让每一个等待算力的业务都能尽快启动。
从"有算力"到"用好算力",中间隔着的正是调度这道桥梁。随着国产算力芯片的多样性持续增加、大模型训练的规模不断扩大,算力调度正在从一个后台技术细节,升级为决定智能化转型成败的关键基础设施。未来的竞争,不仅在于谁拥有更多算力,更在于谁能把已有的算力调度得更聪明、更高效、更经济。


开启你的数字孪生应用之旅